长期以来,设计具有特定功能的蛋白质,往往需要研究者先从天然蛋白质中寻找原型,再进行反复改造与实验筛选。即使借助人工智能,也常常需要将功能需求进一步转化为蛋白质结构、氨基酸位点等专业设计条件。从“我希望蛋白质做什么”到“怎样获得这样的蛋白质”实盘配资平台靠谱吗,中间仍有不小的距离。
由香港科技大学(广州)卢泓远团队联合西湖大学原发杰团队、刘建明团队、中国科学院深圳先进技术研究院司同团队合作开发并验证的蛋白质设计基础模型Pinal解决了这一难题:只需输入一段描述目标功能的文字,模型便能生成候选蛋白质序列,供后续筛选和实验验证。
10月21日,相关成果以“Programmable design of functional proteins from natural language”(基于自然语言的功能蛋白质可编程设计)为题在国际顶级学术期刊《自然》(Nature)发表。
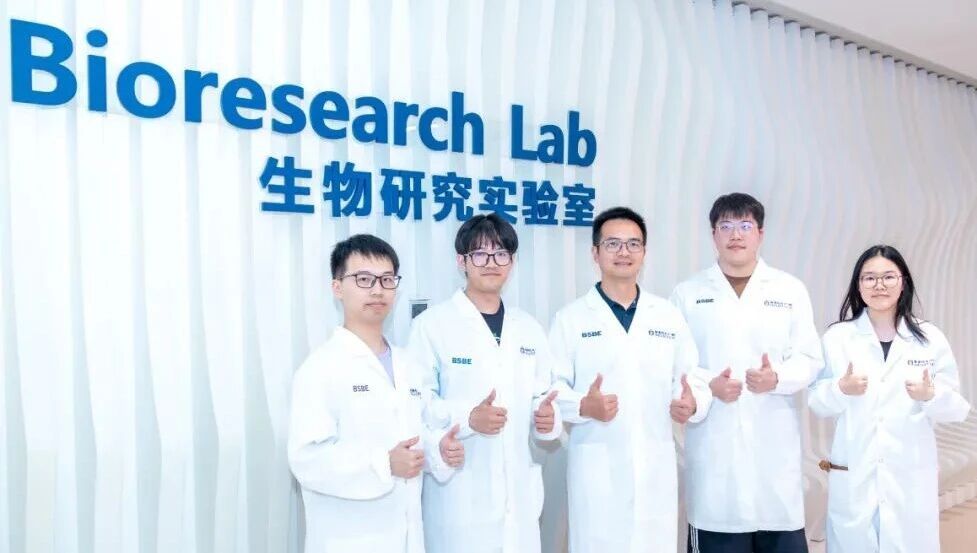
卢泓远(中)团队成员:邓显君(左一)、马晓骁(左二)、游世洋(论文共一作者,右二)、余乐彤(右一)。
从“描述功能”到“生成序列”
长期以来,设计具有特定功能的蛋白质,往往要先从天然蛋白质中寻找原型,再反复改造和实验筛选。即使借助AI,也常需把功能需求转化为蛋白质结构、氨基酸位点等专业设计条件。从“我希望蛋白质做什么”到“怎样获得这样的蛋白质”,中间仍有距离。

港科大(广州)卢泓远团队在国际顶尖期刊《自然》(Nature)上发表最新研究成果。
Pinal试图让自然语言直接成为蛋白质设计起点。团队发现,相较一步到位预测氨基酸序列,先利用文字生成蛋白质结构表示,再基于结构设计序列,是更易学习、也更有效的路径。就像制造机器,先根据用途绘制整体蓝图,再确定每个零件如何安排。Pinal以蛋白质结构为中间桥梁,将自然语言描述转化为候选氨基酸序列。
支撑这一过程的是大规模数据与模型训练:团队构建了包含17亿组蛋白质—文本配对的合成数据集,覆盖约1.35亿条不同蛋白质序列及其结构,训练出约160亿参数的Pinal模型。计算评测显示,随着训练数据和模型规模增大,生成蛋白质与功能描述的匹配程度、预测折叠质量持续改善,并能生成具有一定序列多样性和结构新颖性的候选蛋白质。
四类蛋白实验验证,AI设计走进真实实验
计算预测只是第一步。生成的序列能否正确表达、形成适当结构并在实验中发挥功能,才是“终极考官”。研究团队选择四类代表不同功能和应用场景的蛋白质,全部以文字描述为输入,再通过计算筛选确定候选序列。
第一类是绿色荧光蛋白。团队从优先筛选的29个候选设计中获得具有绿色荧光的pinalGFP;改变发色团形成所需关键氨基酸残基后,荧光信号随之消失,为设计蛋白的发光机制提供实验支持。第二类是能降解PET塑料的水解酶。筛选获得的pinalPETase36不仅能水解模型酯类底物,还能在特定实验条件下作用于固体PET材料,化学分析检测到PET降解产物逐渐积累,电镜观察显示PET表面形成孔洞和凹坑。第三类是具有生物催化价值的醇脱氢酶。设计提示未限定具体亚家族或链长,最终获得5种具有实验活性的醇脱氢酶,覆盖短链、中链及铁依赖型长链三个不同亚家族。第四类是需要与其他酶协同工作的H蛋白,检验的不只是单个蛋白质能否工作,还包括人工设计蛋白能否融入复杂多酶反应体系。
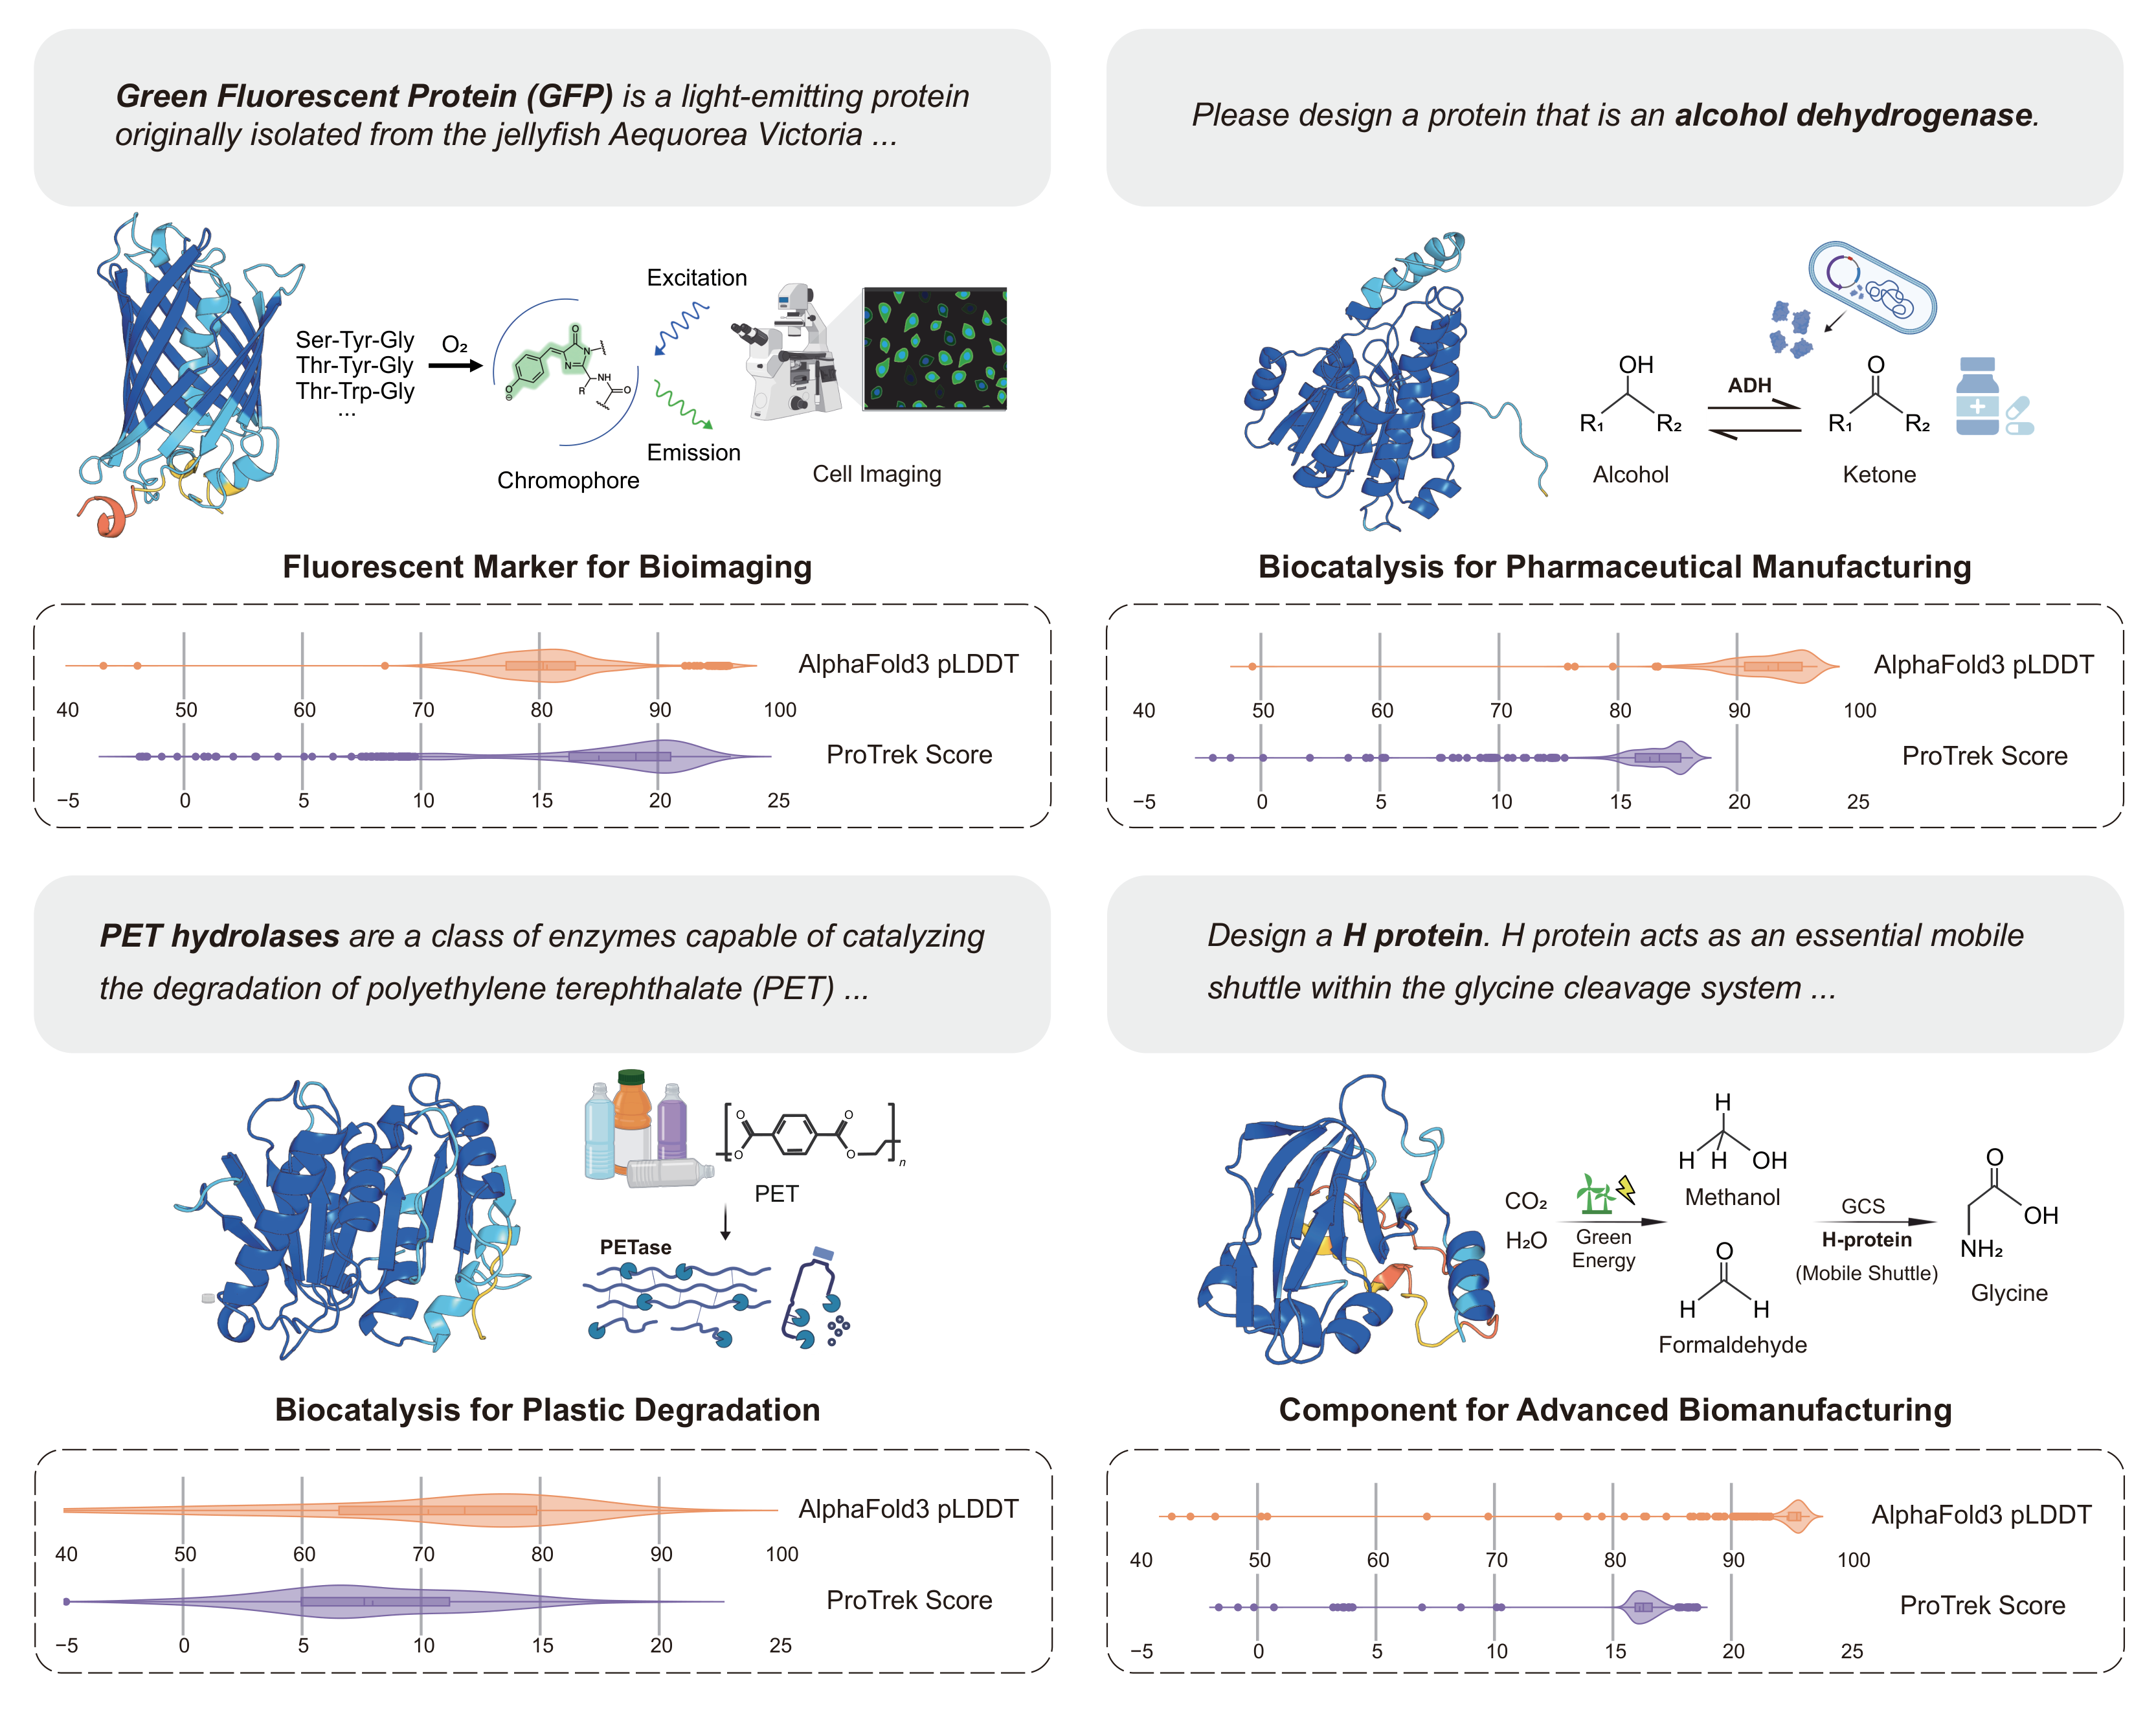
实验过程中的四类功能设计任务。
团队对20个候选H蛋白开展实验测试,其中14个能够可溶表达,5个在重构的体外固碳体系中表现出活性。表现最好的pinalH02使甘氨酸最终浓度达到11.1毫摩尔每升,是采用天然大肠杆菌H蛋白作为对应组件时的1.7倍,相当于产量提高约70%。值得注意的是,这一结果来自初轮设计与筛选,尚未开展迭代实验优化。
这项研究深度融合人工智能、蛋白质工程与生物催化等方向,把AI生成的蛋白质从计算预测带进真实生物实验。Pinal展示了一种更直观的蛋白质设计方式:从希望实现的功能出发,借助AI生成候选方案,再通过实验筛选和验证。未来,随着功能数据更丰富、AI模型与高通量实验技术进一步结合,自然语言驱动的蛋白质设计有望应用于更广泛的生物制造需求。
元股证券:ygzq.hk南方+记者 任燚
配资官方开户通讯员 港科广实盘配资平台靠谱吗
正规品牌券商开户提示:本文来自互联网,不代表本网站观点。
- 上一篇:金融配资推荐 未来五年怎么干?清远英德11位村支书上台晒计划,比学赶超拼实招
- 下一篇:没有了
相关文章
大盘行情指数走势
推荐资讯